
Sakana Fugu: Mô hình orchestration frontier vượt Claude Opus 4.8 trên SWE-bench Pro | Infinity
Sakana Fugu Ultra đạt 73,7% trên SWE-bench Pro, vượt Claude Opus 4.8 (69,2%), GPT-5.5 (58,6%) và Gemini 3.1 Pro (54,2%), ra mắt ngày 22/6/2026 với kiến trúc orchestration thay vì training model lớn hơn. Thay vì cạnh tranh trực tiếp bằng quy mô base model, Sakana AI đặt cược vào một hướng khác: điều phối một pool các frontier model hiện có đằng sau một API OpenAI-compatible duy nhất.
Infinity phân tích kiến trúc Fugu, so sánh benchmark đầy đủ với các model frontier, định giá, và đánh giá khi nào nên cân nhắc thử nghiệm.
Tóm tắt các điểm chính
- Fugu Ultra dẫn đầu 10 trong 11 benchmark theo dữ liệu Sakana công bố, GPT-5.5 chỉ thắng ở MRCRv2 (long-context recall).
- Kiến trúc learned orchestration: Fugu học cách quyết định khi nào delegate, không yêu cầu developer định nghĩa pipeline thủ công.
- Routing layer hoàn toàn không minh bạch, không thể audit model nào xử lý request, là hạn chế thực sự cho compliance-sensitive work.
- Fugu Ultra chưa khả dụng tại EU/EEA trong khi Sakana hoàn thiện GDPR compliance, chưa có timeline cụ thể.
- Toàn bộ benchmark do Sakana tự công bố, chưa có bên thứ ba độc lập tái kiểm chứng tại thời điểm bài viết.
Sakana Fugu là gì và kiến trúc hoạt động ra sao
Sakana Fugu là một language model được train để đóng vai trò orchestrator: nhận request, quyết định xử lý trực tiếp hay delegate cho specialist model trong agent pool, quản lý verification và synthesis, rồi trả về một response duy nhất. Từ phía ngoài bạn gọi một endpoint. Bên trong, một tập hợp model phối hợp thực hiện công việc.
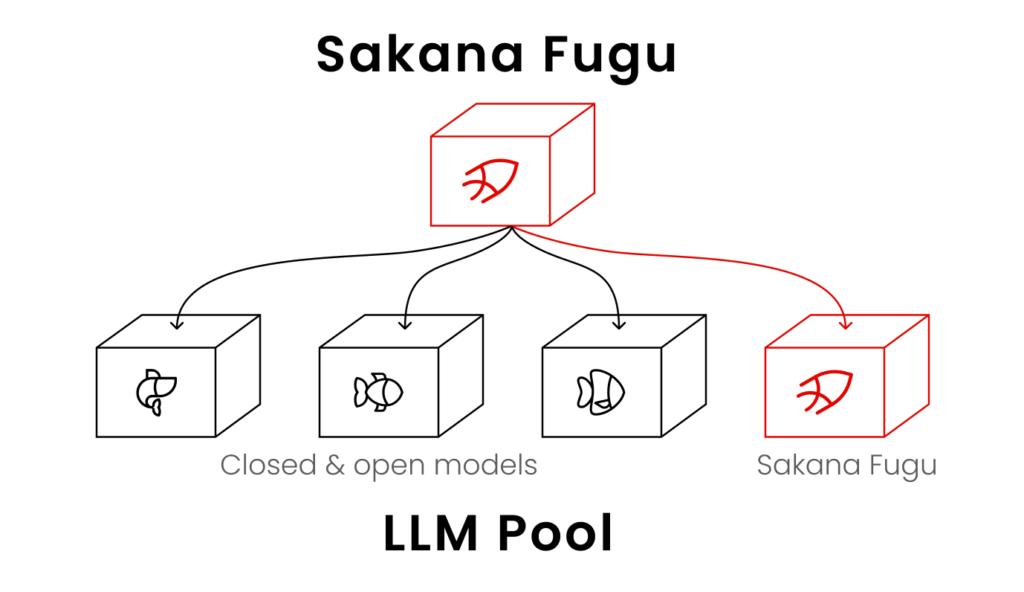
Sakana AI được thành lập bởi Llion Jones, đồng tác giả paper "Attention Is All You Need", và David Ha. Lab này từ lâu lập luận rằng coordinated model ecosystem vượt trội isolated monolith trên các tác vụ khó, dài hơi. Fugu là phiên bản được đưa ra sản phẩm của luận điểm đó, xây dựng trên hai paper tại ICLR 2026: TRINITY (evolved LLM coordinator) và Conductor (học cách orchestrate agent bằng ngôn ngữ tự nhiên).
Fugu ra mắt với hai biến thể:
- Fugu cho tác vụ hàng ngày có yêu cầu latency thấp
- Fugu Ultra cho tác vụ phức tạp, nhiều bước
Lưu ý: Tại thời điểm bài viết, Anthropic Fable 5 và Mythos Preview không khả dụng công khai do kiểm soát xuất khẩu, không thể đưa vào agent pool của Fugu.
4 tính năng phân biệt Fugu với multi-agent framework thông thường
1. Learned orchestration thay vì fixed pipeline
Fugu học quyết định khi nào delegate, model nào xử lý tác vụ nào, và cách tổng hợp output, thay vì yêu cầu developer viết pipeline thủ công. Đây là đóng góp cốt lõi từ nghiên cứu TRINITY và Conductor.
Trong thực tế, độ phức tạp của hệ thống multi-agent không bao giờ chạm đến code của bạn. Bạn gửi request đến một endpoint, Fugu xử lý model selection, delegation, verification và synthesis nội bộ.
Caveat quan trọng: Routing decision là proprietary và không được expose cho người dùng. Bạn không thể thấy model nào đã xử lý một request cụ thể. Với compliance-sensitive work cần audit reasoning chain, đây là hạn chế thực sự, không phải nhỏ.
2. Swappable agent pool
Pool model trong Fugu không cố định: khi một frontier model mới trở nên publicly available, Sakana dự kiến mất khoảng hai tuần để train và evaluate Fugu model cập nhật trước khi triển khai. Hiệu suất của Fugu sẽ cải thiện cùng với hệ sinh thái, không yêu cầu người dùng thay đổi integration.
- Fugu standard: Người dùng có thể opt specific agent ra khỏi pool từ console settings, phù hợp cho team có yêu cầu data privacy hoặc compliance.
- Fugu Ultra: Pool cố định vì phụ thuộc vào toàn bộ tập agent để đạt hiệu suất benchmark.
3. Thiết kế hai tầng theo workload
Fugu cân bằng chất lượng với latency thấp cho tác vụ coding và interactive service. Fugu Ultra điều phối pool agent sâu hơn, tối ưu cho chất lượng tối đa trên bài toán khó nhiều bước.
Người dùng beta đã dùng Fugu Ultra cho:
- Paper reproduction
- Cybersecurity analysis
- Data science dạng Kaggle
- Patent investigation
Feedback từ beta:
- Một software engineer báo cáo Fugu Ultra phát hiện hơn 20 vấn đề trong code review, trong khi các tool khác chỉ flag khoảng 3.
- Một cybersecurity engineer báo cáo một instruction duy nhất đã drive toàn bộ security assessment đầu đến cuối, bao gồm report sạch với evidence và retest step.
Đánh đổi latency: Routing và synthesis nhiều agent tốn thêm overhead. Với query đơn giản hoặc yêu cầu latency chặt, gọi trực tiếp một frontier model sẽ nhanh hơn và rẻ hơn.
4. API OpenAI-compatible, không cần migration SDK
Fugu và Fugu Ultra đều truy cập qua một API OpenAI-compatible duy nhất. Bạn trỏ client hiện tại về Fugu endpoint với API key và bắt đầu gửi request. Đây là lựa chọn có chủ đích để giảm switching cost cho team đang dùng GPT-5.5 hoặc Claude Opus 4.8 qua OpenAI client library.
Benchmark đầy đủ: Fugu Ultra dẫn đầu 10/11 tiêu chí
Benchmark Fugu Fugu Ultra Opus 4.8 Gemini 3.1 Pro GPT-5.5 SWE-bench Pro 59,0% 73,7% 69,2% 54,2% 58,6% TerminalBench 2.1 80,2 82,1 74,6 70,3 78,2 LiveCodeBench 92,9 93,2 87,8 88,5 85,3 LiveCodeBench Pro 87,8 90,8 84,8 82,9 88,4 Humanity's Last Exam 47,2 50,0 49,8 44,4 41,4 CharXiv Reasoning 85,1 86,6 84,2 83,3 84,1 GPQA Diamond 95,5 95,5 92,0 94,3 93,6 SciCode 60,1 58,7 53,5 58,9 56,1 τ3 Banking 21,7 20,6 20,6 8,4 20,6 Long context reasoning 74,7 73,3 67,7 72,7 74,3 MRCRv2 86,6 93,6 87,9 84,9 94,8† Điểm Opus 4.8, Gemini 3.1 Pro, GPT-5.5 do provider tự công bố. Toàn bộ điểm Fugu do Sakana công bố, chưa có bên thứ ba tái kiểm chứng độc lập.
SWE-bench Pro: khoảng cách 15 điểm so với GPT-5.5
Fugu Ultra đạt 73,7% trên SWE-bench Pro, vượt model publicly accessible gần nhất là Claude Opus 4.8 (69,2%) và bỏ xa GPT-5.5 (58,6%) 15 điểm. SWE-bench Pro đo khả năng giải quyết GitHub issue thực tế trong software repository, là một trong số ít benchmark có tương quan rõ với công việc coding thực tế. Khoảng cách này đủ lớn để có ý nghĩa với team làm code review hoặc bug-fixing nghiêm túc.
Humanity's Last Exam: khoảng cách lớn nhất so với GPT-5.5
Fugu Ultra đạt 50,0% trên Humanity's Last Exam, khoảng cách với GPT-5.5 (41,4%) là lớn nhất trong toàn bộ bảng benchmark. Benchmark này kiểm tra kiến thức chuyên gia cấp độ PhD trên nhiều lĩnh vực khoa học và học thuật, với câu hỏi được thiết kế khó ngay cả với chuyên gia trong ngành.
GPQA Diamond: Fugu standard ngang Fugu Ultra
Cả Fugu và Fugu Ultra đều đạt 95,5% trên GPQA Diamond, cao hơn Gemini 3.1 Pro (94,3%) và GPT-5.5 (93,6%). Việc Fugu standard ngang Fugu Ultra ở đây cho thấy orchestration overhead không mang lại lợi thế thêm trên tác vụ question-answering không cần multi-step planning.
MRCRv2: điểm duy nhất Fugu Ultra không dẫn đầu
GPT-5.5 thắng MRCRv2 với 94,8%, Fugu Ultra đạt 93,6%. MRCRv2 kiểm tra long-context recall, cụ thể khả năng truy xuất thông tin cụ thể từ tài liệu rất dài. Đây là điểm cần lưu ý cho team có use case chính là tra cứu dữ kiện từ tài liệu lớn hơn là reasoning hoặc code generation nhiều bước.

Định giá Sakana Fugu
Fugu khả dụng tại console.sakana.ai với API OpenAI-compatible. Cả Fugu và Fugu Ultra đều có mặt trong mọi gói.
Subscription plan
Gói Giá/tháng Phù hợp với Standard $20 API call thỉnh thoảng, thử nghiệm cá nhân Pro $100 Coding và research session thường xuyên (10× Standard) Max $200 Workload nặng, dài hơi (30× Standard)Pay-as-you-go (Fugu Ultra, model ID: fugu-ultra-20260615)
Loại Context ≤ 272K token Context > 272K token Input $5 / 1M token $10 / 1M token Output $30 / 1M token $45 / 1M token Cached input $0,50 / 1M token $1,00 / 1M tokenLưu ý:
- Fugu standard tính theo giá của model underlying đang active.
- Sakana không stack phí khi nhiều agent chạy đồng thời.
- Context window tối đa của Fugu Ultra là 1.000.000 token.
- Pricing tiêu chuẩn áp dụng cho 272.000 token đầu tiên.
Rào cản quan trọng
Fugu hiện không khả dụng tại EU và EEA trong khi Sakana hoàn thiện GDPR compliance. Sakana chưa công bố timeline cụ thể. Với team châu Âu, đây là rào cản thực sự ở thời điểm hiện tại.
Kết luận
Fugu là một hướng đi thực sự khác với những gì OpenAI, Anthropic và Google đang làm, và benchmark numbers, nếu được bên thứ ba tái kiểm chứng, hỗ trợ lập luận đó trên phần lớn các tiêu chí quan trọng với developer.
Infinity nhận định trường hợp thuyết phục nhất cho Fugu Ultra là team đang chạy long-horizon agentic workflow và đã tự duy trì orchestration harness trên nhiều model. Nếu bạn đang tự quản lý stack điều phối Claude và GPT, Fugu Ultra đáng được đưa vào evaluation nghiêm túc.
Ba caveat cần giữ trong đầu:
- Toàn bộ benchmark do Sakana tự công bố và chưa được tái kiểm chứng độc lập.
- Routing layer không minh bạch tạo ra rào cản thực sự với compliance-sensitive work.
- Overhead orchestration trên tác vụ đơn giản là chi phí thuần không mang lại lợi ích.
Framing "AI sovereignty" mà Sakana đưa ra có phần được thổi phồng, nhưng giá trị thực tế của một single endpoint có khả năng route around provider disruption là có thật.
Link nội dung: https://melodious.edu.vn/sakana-la-gi-a116536.html